
Większość kopii zapasowych w IT tworzy się z myślą o awariach sprzętowych czy błędach ludzkich. W takich przypadkach backup jest jak klasyczne koło ratunkowe: leży gdzieś i czeka na swój moment (a wszyscy często biorą na wiarę to, że w razie potrzeby faktycznie zadziała).
W przypadku ransomware czy innego ataku cyberprzestępców reguły gry diametralnie się jednak zmieniają.
Atakujący doskonale wiedzą, że dobrze przygotowana procedura odzyskiwania danych niweczy ich szanse na okup (lub osiągnięcie innego celu, np. zniszczenia infrastruktury IT). Dlatego zanim zaczną realizować swój główny plan i ujawnią się firmie, spędzają w przejętej sieci dni (a czasem i tygodnie) na cichym rozpoznaniu systemów oraz procedur. Ich pierwszym i najważniejszym celem wcale nie są dane czy systemy produkcyjne. Są nimi Twoje kopie zapasowe.
Jeśli atakujący przejmie uprawnienia administratora i skasuje kopie zapasowe, usunie punkty przywracania czy nadpisze je zaszyfrowanymi danymi, zostajesz z niczym. Firma nie może wznowić operacji po ataku, przestaje zarabiać, a Ty w panice zostajesz na łasce przestępcy i musisz spełnić jego żądania. Warto też pamiętać, że ulegnięcie szantażowi wcale nie gwarantuje odzyskania danych. Atakujący może po prostu zniknąć po odebraniu wpłaty, a dostarczone przez niego narzędzie lub klucz deszyfrujący może zwyczajnie nie zadziałać.
Sam fakt, że „co noc robi się backup”, daje dziś złudne poczucie bezpieczeństwa. Aby naprawdę zabezpieczyć ciągłość działania firmy, musimy zmienić myślenie: proces tworzenia kopii zapasowych musi być projektowany w oparciu o konkretne scenariusze. Musimy zadać sobie pytania:
- Co, jeśli odtworzenie kopii nie zadziała?
- Co, jeśli atakujący zaszyfruje kopie?
- Co, jeśli serwer, na którym je trzymamy, ulegnie awarii?
- Co, jeśli ktoś z administratorów (lub atakujący za pomocą jego uprawnień) po prostu je usunie?
W tym artykule przejdziemy ścieżkę budowania nowoczesnych i odpornych na ataki kopii zapasowych. Porozmawiamy o higienie backupów, rozwiązaniach dostępnych w chmurze Azure, ale też o tym, jak osiągnąć te same cele przy użyciu narzędzi open source. Zapraszam do lektury!
Fundamenty i higiena tworzenia kopii zapasowych
Zanim przejdziemy do konkretnych rozwiązań czy narzędzi, musimy najpierw porozmawiać o fundamentach i higienie tworzenia kopii zapasowych. Niezależnie od tego, z czego korzystacie, to właśnie te podstawy są najważniejsze. Najdroższe oprogramowanie i najbardziej skomplikowane zabezpieczenia nie ochronią Twoich danych, jeżeli zawiodą podstawowe procesy. Nie montuje się w końcu pancernych drzwi do budynku, w którym okna są otwarte na oścież 🙂
Największym błędem w IT jest traktowanie backupu jako zadania w stylu „ustaw i zapomnij”. Administratorzy konfigurują harmonogram, uruchamiają zadanie, dostają informację ze statusom w zielonym kolorze „Ukończono” i na tym kończą cały proces. Problem w tym, że status „Ukończono” oznacza tylko tyle, że proces wykonywania kopii dobiegł końca, nie oznacza natomiast, że ta kopia jest sprawna i faktycznie da się z niej odzyskać dane.
Dlatego pierwszym i najważniejszym punktem na naszej liście jest okresowe testowanie kopii zapasowych. Oczywiście nie trzeba tego robić codziennie po każdym wykonanym backupie, ale raz w miesiącu czy raz na kwartał warto przeprowadzić taki test: odtworzyć systemy z kopii w pełni (np. do odizolowanego środowiska) i sprawdzić, czy wszystko działa prawidłowo. Próby te szybko wykażą, czy Wasza firma jest faktycznie gotowa na atak i będzie w stanie się po nim podnieść. Da Wam to o wiele większy spokój ducha niż ślepa wiara w to, że „jakoś to będzie, bo przecież robimy kopie”.
Kolejna ważna kwestia to tworzenie kopii zapasowych w oparciu o klasyczną zasadę 3-2-1. Co ona dokładnie oznacza?
- 3 kopie danych: Należy przechowywać łącznie trzy kopie danych, jedną główną (produkcyjną) oraz dwie niezależne kopie zapasowe.
- 2 różne nośniki: Kopie zapasowe należy przechowywać na co najmniej dwóch różnych rodzajach nośników, technologii lub urządzeń.
- 1 kopia off-site: Co najmniej jedna kopia zapasowa musi znajdować się w innej lokalizacji fizycznej, poza głównym centrum danych firmy. Najlepiej, jeśli jest przy tym offline lub air-gapped (odizolowana, bez stałego dostępu do sieci).
Tak wielopoziomowa nadmiarowość daje nam pewność, że dane będą bezpieczne w przypadku najróżniejszych zdarzeń losowych, takich jak awaria nośników, uszkodzenie sprzętu, pożar czy kradzież.
Przykładem dobrze wdrożonej zasady 3-2-1 może być następujący scenariusz:
Firma posiada dane produkcyjne na swoich serwerach aplikacyjnych oraz dwie niezależne kopie zapasowe. Pierwsza kopia trafia na dedykowany, odizolowany serwer backupowy w głównym biurze. Druga kopia jest automatycznie replikowana do bezpiecznego magazynu w chmurze (dwa różne nośniki/technologie). Dodatkowo, co tydzień administratorzy zgrywają dane na dysk zewnętrzny lub taśmę LTO (oldschool, ale wciąż potężny!), który trafia do sejfu w zupełnie innej lokalizacji firmy (jedna kopia off-site / offline).
Warto też oczywiście pamiętać, że w przypadku infrastruktury lokalnej, aby Wasze kopie faktycznie były bezpieczne, trzeba zapewnić odpowiednią nadmiarowość sprzętową i środowiskową: klastrowanie, macierze RAID, zasilanie awaryjne (UPS-y) i tym podobne rozwiązania.
Do tego nowoczesne systemy do kopii zapasowych pozwalają na wdrożenie kilku dodatkowych funkcji, które (wszędzie tam, gdzie to możliwe) powinny być bezwzględnie uruchomione:
- Immutability (Niezmienność): Możliwość zablokowania punktów przywracania w taki sposób, aby absolutnie nikt (nawet administrator domenowy czy Global Admin w chmurze) nie mógł ich zmodyfikować ani usunąć przed upływem wyznaczonego czasu.
- Versioning (Wersjonowanie): Tworzenie kolejnych wersji plików, jeśli dane zostaną zmodyfikowane, system przechowa nową wersję obok poprzednich, do których wciąż będzie można wrócić.
- Soft Delete (Miękkie usuwanie): Mechanizm sprawiający, że skasowana kopia nie znika natychmiast, lecz trafia do „koszyka” na określoną liczbę dni (np. 14 lub 30) i w tym czasie może zostać bez problemu odzyskana.
Zależnie od tego, co wspiera Wasz system, powinniście wdrożyć te mechanizme, przy czym zdecydowanie najlepszym i najbardziej bezkompromisowym rozwiązaniem jest wymuszenie Immutability.
Dzięki niemu, jeśli złośliwe oprogramowanie spróbuje nadpisać i zaszyfrować Wasze kopie zapasowe, operacja ta po prostu się nie powiedzie. Mechanizm ten działa identycznie w przypadku działań administracyjnych, nikt z wysokimi uprawnieniami (ani uprawniony pracownik popełniający błąd, ani atakujący podszywający się pod niego) nie będzie w stanie skasować ani zmienić kopii. Funkcja ta sprawia, że kopie zapasowe stają się faktycznie pancerne. Wersjonowanie i Soft Delete również stanowią cenny bufor bezpieczeństwa, jednak nie dają aż tak wysokiego poziomu zaufania i ochrony jak pełne Immutability.
Wasze kopie zapasowe (zarówno te główne, jak i nadmiarowe) muszą być też zawsze szyfrowane. Szyfrowanie to powinno działać na dwóch poziomach:
- Encryption in transit (w ruchu): Dane są szyfrowane podczas transmisji sieciowej pomiędzy lokalizacjami (np. za pomocą szyfrowanych połączeń SSL/TLS czy tuneli VPN).
- Encryption at rest (w spoczynku): Dane są zaszyfrowane w miejscu ich przechowywania na serwerach czy macierzach (np. poprzez szyfrowanie fizycznych dysków lub zasobów pamięci masowej).
I na sam koniec, jeden z filarów architektury Zero Trust, czyli zasada najmniejszych przywilejów (Least Privilege Access).
Nadając pracownikom IT dostępy do systemów backupowych, musimy ściśle ograniczać ich zakres. Dany pracownik powinien otrzymać wyłącznie takie uprawnienia, które są mu niezbędne do wykonywania codziennych zadań. Bardzo dobrym podejściem jest również to, aby te uprawnienia nie były przypisane na stałe, lecz aktywowane czasowo tylko wtedy, gdy faktycznie trzeba wykonać konkretną pracę (Just-in-Time).
Z kolei najbardziej krytyczne i newralgiczne operacje na kopiach zapasowych powinny wymagać autoryzacji przez co najmniej dwie osoby (zasada Two-Person Integrity / podwójnego zatwierdzenia), na przykład administratora kopii zapasowych oraz administratora bezpieczeństwa. Jedna osoba nigdy nie powinna mieć możliwości samodzielnej decyzji o całkowitym usunięciu bazy backupów czy zatrzymaniu procesu ich tworzenia.
Ochrona kopii zapasowych w Microsoft Azure
Zanim przejdziemy do dokładnego omawiania bezpieczeństwa kopii zapasowych w Microsoft Azure, musimy wyjaśnić kilka pojęć, które często przewijają się w dyskusjach o backupach i bywają mylone nawet przez doświadczonych adminów. Są to:
- Azure Backup: Nazwa całego ekosystemu i usługi w chmurze Microsoftu, pod którą kryją się poszczególne rozwiązania odpowiedzialne za tworzenie i zarządzanie kopiami. Aktualnie główny panel do zarządzania tą usługą w portalu Azure nazywa się Resiliency (usługi backupu zostały zunifikowane w jednym miejscu razem z mechanizmami business continuity i disaster recovery).
- Backup Vault: „Nowszy” magazyn, zaprojektowany z myślą o nowoczesnych usługach typu cloud-native oraz danych w formacie blob/object storage.
- Recovery Services Vault (RSV): „Starszy”, ale znacznie bardziej uniwersalny magazyn, który obsługuje tradycyjne obciążenia (workloads), takie jak maszyny wirtualne i usługi compute w Azure, serwery on-premise i inne.
Tak jak wspomniałem wyżej, Azure Backup potrafi robić kopie zapasowe nie tylko usług działających natywnie w chmurze Azure, ale też serwerów on-premise czy obciążeń u innych dostawców chmurowych, takich jak AWS czy GCP (o czym wiele osób nadal nie wie!). Robi się to przy pomocy dwóch głównych mechanizmów:
- Azure Arc (z rozszerzeniami): Pozwala podpiąć zewnętrzny serwer pod chmurę Azure i zarządzać nim z jednego panelu. Niezależnie od tego, czy maszyny działają na lokalnym Hyper-V/VMware, czy w chmurach AWS czy GCP, proces uruchomienia backupu sprowadza się do wyklikania go w portalu Azure. Platforma automatycznie dociągnie na maszynę odpowiednie rozszerzenie (Arc extension), które zajmie się wykonywaniem kopii zapasowych bez konieczności ręcznego dłubania i instalowania cokolwiek na serwerze.
- Serwer MABS (Microsoft Azure Backup Server): Używany w bardziej skomplikowanych scenariuszach on-premise, gdzie oprócz samych plików czy stanu systemu potrzebujemy zaawansowanego backupu aplikacyjnego (np. dla lokalnych baz SQL Server, Exchange czy kopii plików typu Bare Metal).
Konfigurując nasz magazyn (Vault), możemy od razu wybrać, jaki stopień redundancji chcemy mu zapewnić (rozwiązuje to część wymagań zasady 3-2-1 out-of-the-box, bez konieczności wdrażania dodatkowych narzędzi). Do wyboru mamy:
- LRS (Locally-Redundant Storage): Replikacja danych w obrębie jednego centrum danych w danej strefie dostępności. Dane są zapisywane w trzech osobnych kopiach na różnym sprzęcie (np. w innych szafach rackowych). Chroni nas to przed zwykłą awarią pojedynczego dysku czy serwera.
- ZRS (Zone-Redundant Storage): Replikacja danych pomiędzy trzema różnymi strefami dostępności (Availability Zones) w ramach tego samego regionu Azure. Oznacza to, że kopie trafiają do fizycznie osobnych budynków/datacenters, co chroni nas przed awarią całego obiektu.
- GRS (Geo-Redundant Storage): Replikacja na poziomie odrębnych regionów geograficznych Microsoft Azure. Dane trafiają do drugiego, sparowanego regionu (oddalonego często o setki kilometrów od głównego). Ta opcja daje najwyższy poziom ochrony, zabezpiecza nas przed awariami na skalę całego regionu czy wręcz klęskami żywiołowymi.
GRS posiada również dodatkową funkcję o nazwie CRR (Cross Region Restore). Pozwala ona na odtworzenie naszych zasobów i kopii zapasowych bezpośrednio w drugim, sparowanym regionie i to bez konieczności czekania, aż Microsoft oficjalnie ogłosi awarię regionu głównego. Funkcja ta mocno zahacza już jednak o automatyzację planów Disaster Recovery oraz utrzymanie ciągłości działania (Business Continuity), co wykracza poza zakres tego artykułu (warto jednak o niej pamiętać, jeśli wymaga tego nasz biznes).
Pamiętajcie jednak, że im wyższe wymagania dotyczące ochrony danych i im więcej zaawansowanych funkcji uruchomicie, tym bezpieczniejsze będą Wasze kopie, ale też tym wyższy będzie rachunek za chmurę. Dlatego zanim wdrożycie rozwiązanie typu state-of-the-art, warto dokładnie zweryfikować, czego naprawdę potrzebuje Wasz biznes i dobrać funkcje odpowiednio do budżetu.
Dobrą praktyką jest też kategoryzacja danych i podział na te, które możecie stracić (lub wymagają mniejszej ochrony), oraz te absolutnie kluczowe dla funkcjonowania firmy. Dla zasobów krytycznych warto uruchomić najbardziej zaawansowane opcje replikacji i bezpieczeństwa, podczas gdy dla pozostałych zastosować prostsze mechanizmy, co pozwoli Wam mocno zoptymalizować koszty.
Jeśli chodzi o typową ochronę samych kopii zapasowych w Microsoft Azure, mamy tutaj dwie kluczowe opcje.
Pierwszą z nich jest Immutability, czyli niezmienność kopii. Po włączeniu tej funkcji nawet Global Admin czy właściciel subskrypcji nie może usunąć ani zmodyfikować kopii zapasowej przed upływem ustalonego okresu retencji. Funkcję tę uruchamiamy bezpośrednio w ustawieniach (Properties) magazynu Recovery Services Vault lub Backup Vault. Jest to absolutnie najlepsza ochrona przed złośliwym oprogramowaniem typu ransomware (które mogłoby chcieć nadpisać nasze kopie) oraz przed atakiem wewnątrz sieci, gdy włamywacz próbuje skasować backupy. Konfigurując Immutable Vault, opieramy czas trwania tej ochrony na zdefiniowanych politykach retencji lub na określonej liczbie dni od momentu utworzenia kopii.
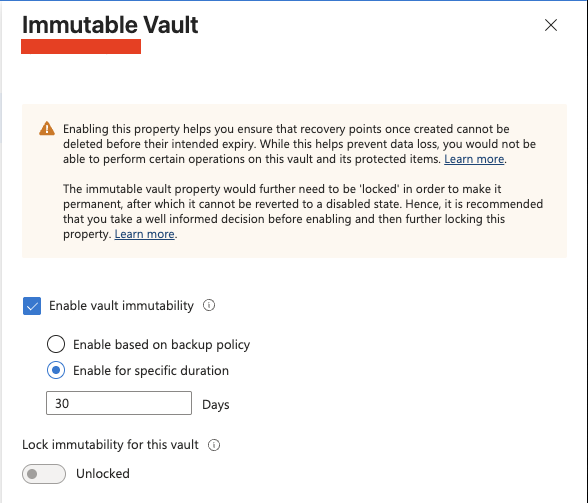
Jeśli naprawdę zależy nam na maksymalnym poziomie bezpieczeństwa, powinniśmy dodatkowo zaznaczyć opcję „Lock immutability for this vault”. Dzięki temu nikt nie będzie w stanie wyłączyć tej funkcji ani złagodzić jej reguł. Ewentualne cofnięcie tej decyzji wymagałoby całkowitego usunięcia i ponownego wdrożenia (redeploy) całego Vaulta wraz ze wszystkimi przechowywanymi w nim danymi.
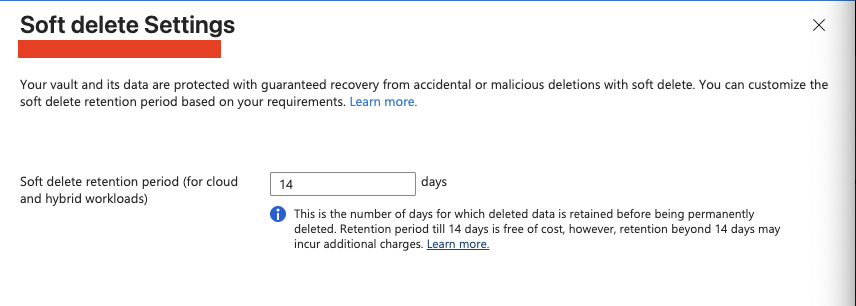
Drugą opcją jest Soft Delete (miękkie usuwanie). Działa ona na zasadzie wirtualnego „kosza”, po przypadkowym lub celowym usunięciu punktu przywracania, nasza kopia zapasowa nie znika od razu bezpowrotnie, lecz trafia do bufora, gdzie jest przechowywana przez określoną liczbę dni (domyślnie 14) i skąd w każdej chwili można ją przywrócić. Tę funkcję również konfigurujemy wprost z poziomu ustawień (Properties) naszego magazynu.
Nasze kopie zapasowe musimy też chronić przed błędami ludzkimi oraz tzw. insider threat (np. mściwym pracownikiem w trakcie offboardingu, który przed odejściem postanowi narobić szkód). W tym celu Microsoft Azure oferuje mechanizm Multi-User Authorization (MUA), realizowany przy pomocy zasobu Resource Guard.
W praktyce działa to jak zasada „dwóch par oczu”, wykonanie jakichkolwiek krytycznych działań administracyjnych na backupach (np. usunięcie magazynu, skracanie polityki retencji czy próba wyłączenia Soft Delete) wymaga zatwierdzenia akcji przez co najmniej dwóch różnych użytkowników (np. administratora kopii zapasowych oraz administratora bezpieczeństwa).
Samą funkcję konfigurujemy w ustawieniach (Properties) naszego magazynu, ale sam obiekt Resource Guard musimy zdeployować osobno, najlepiej w innej subskrypcji, a w scenariuszu maksymalnie bezpiecznym: w całkowicie osobnym tenancie Entra ID. Dzięki temu, nawet jeśli haker lub mściwy pracownik przejmie pełne uprawnienia administratora w naszym głównym środowisku, i tak nie będzie w stanie samodzielnie znieść ochrony ani skasować kopii zapasowych.
Skoro mowa o uprawnieniach, to (tak jak wspomniałem w pierwszej sekcji artykułu) powinniśmy zawsze kierować się architekturą Zero Trust oraz zasadą Least Privilege. Każdy pracownik (w tym administrator systemów IT) powinien posiadać wyłącznie takie uprawnienia, jakie są mu niezbędne do wykonania konkretnych zadań, i to tylko do zasobów, do których faktycznie potrzebuje dostęp.
Warto również wdrożyć dostęp typu Just-In-Time (JIT) przy pomocy usługi Microsoft Entra PIM (Privileged Identity Management). Dzięki temu użytkownik nie posiada stałych uprawnień administracyjnych, lecz wnioskuje o ich przyznanie tylko wtedy, gdy są mu naprawdę potrzebne (co często wymaga zatwierdzenia przez drugą osobę), a dostęp nadawany jest wyłącznie na określony czas.
Jeśli chcemy iść o krok dalej, powinniśmy wprowadzić osobne konta administracyjne dla działu IT, tak aby inżynierowie nie zarządzali infrastrukturą z tych samych kont, na których odbierają codzienną pocztę służbową czy przeglądają sieć. Absolutnym zwieńczeniem tych dobrych praktyk jest wykorzystanie dedykowanych, odpowiednio zabezpieczonych i stale monitorowanych stacji roboczych przeznaczonych wyłącznie do prac administracyjnych (tzw. PAW – Privileged Access Workstations).
W ramach zasady Zero Trust (Assume Breach) musimy projektować naszą sieć i dostępy wychodząc z założenia, że ktoś niepożądany już przełamał pierwsze linie obrony i znajduje się wewnątrz infrastruktury. W związku z tym kluczowe jest stosowanie odpowiedniej segmentacji oraz szyfrowania na każdym etapie.
To samo dotyczy oczywiście chmury. Domyślnie Azure Backup przesyła kopie zapasowe przez sieć publiczną (dane są ciągle szyfrowane, ale ruch idzie po publicznych punktach końcowych). Jeśli chcemy, aby nasz ruch backupowy przemieszczał się wyłącznie połączeniami prywatnymi wewnątrz bezpiecznej sieci Microsoftu (Microsoft backbone network), powinniśmy skonfigurować dla naszych magazynów Private Endpoints i przypisać im prywatną adresację IP z naszej sieci VNet. Następnie musimy upewnić się, że nasze usługi łączą się z Vaultem właśnie przez te prywatne punkty (same Private Endpoints możemy łatwo skonfigurować w panelu Vaulta, przechodząc do zakładki Settings -> Networking -> Private Access).
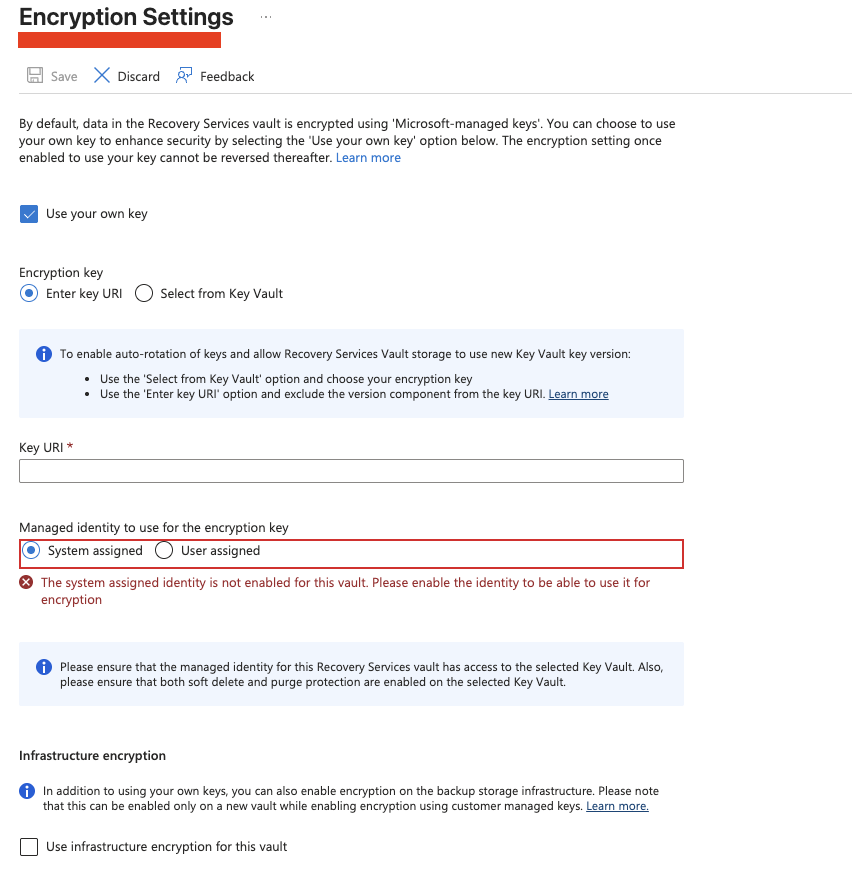
Warto też wiedzieć, że Microsoft automatycznie szyfruje nasze kopie zapasowe zarówno w ruchu (in transit), jak i w spoczynku (at rest). Domyślnie używa do tego kluczy szyfrujących zarządzanych przez siebie (Microsoft-managed keys).
Może się jednak zdarzyć, że wewnętrzne polityki bezpieczeństwa lub rygorystyczne normy compliance wymuszają na Waszym biznesie pełną kontrolę nad kryptografią. W takiej sytuacji możecie przełączyć tę funkcję i dostarczyć własne klucze, którymi będziecie zarządzać samodzielnie (Customer-Managed Keys – CMK). Funkcję tę konfiguruje się bezpośrednio w zakładce Properties naszego Vaulta. Klucze te mogą być bezpiecznie przechowywane w usłudze Azure Key Vault lub podlinkowane za pomocą URI (jeśli korzystacie z własnego, zewnętrznego rozwiązania KMS).
W oknie konfiguracji znajdziecie również opcję włączenia tzw. Infrastructure Encryption (podwójnego szyfrowania), która zapewnia dodatkową warstwę szyfrowania sprzętowej infrastruktury (dysków), na której fizycznie spoczywa Wasz magazyn.
Oczywiście samo odpowiednie zabezpieczenie kopii zapasowych nie wystarczy, kluczowe jest również ciągłe monitorowanie wszelkich operacji na nich wykonywanych pod kątem wykrywania anomalii oraz potencjalnych ataków.
Jeśli chcemy pozostać w ekosystemie Microsoftu, warto wykorzystać w tym celu Microsoft Defender for Cloud. Będzie on na bieżąco analizował konfigurację naszych magazynów i wykrywał podejrzane zachowania (np. nagłe próby masowego usuwania kopii czy modyfikacji polityk retencji). Wszystkie logi audytowe oraz zdarzenia zgłoszone przez Defendera warto następnie przesyłać bezpośrednio do systemu SIEM (np. natywnego Microsoft Sentinela lub alternatywnego rozwiązania klasy Open Source, takiego jak Wazuh SIEM/XDR). Umożliwi to pełną korelację zdarzeń, dalszą analitykę oraz sprawną obsługę incydentów przez zespół IT lub dział bezpieczeństwa.
Ochrona kopii zapasowych w oparciu o Open Source
Jeżeli Wasza infrastruktura opiera się na środowisku on-premise lub szukacie alternatywnego rozwiązania klasy Open Source, warto zainteresować się systemem Proxmox Backup Server (PBS). Pozwala on na natywną integrację z Proxmox Virtual Environment (PVE) i tworzenie przyrostowych kopii zapasowych maszyn wirtualnych. Dodatkowo oferuje dedykowanego agenta, którego możemy zainstalować na systemach spoza tego środowiska (w tym na serwerach fizycznych), aby wykonywać kopie na poziomie plików (file-level backup).
PBS wspiera również szyfrowanie po stronie klienta (Client-Side Encryption), precyzyjne zarządzanie uprawnieniami do poszczególnych repozytoriów (datastore) czy przestrzeni (namespaces), a także integrację z usługami katalogowymi (LDAP/AD) oraz wymuszenie wieloskładnikowego uwierzytelniania (MFA) dla administratorów. Co istotne, system natywnie obsługuje biblioteki taśmowe (LTO), które stanowią „złotego Graala”, jeśli chodzi o pełną fizyczną niezmienność danych oraz realizację zasady WORM (Write Once, Read Many).
W celu stworzenia bezpiecznej architektury możemy uruchomić kilka instancji PBS i połączyć je w strukturę hierarchiczną, np. jeden główny serwer backupu per lokalizacja (co pozwala sprawnie wykonywać kopie lokalne i zminimalizować obciążenie łącz) oraz dodatkowy serwer off-site pełniący rolę zewnętrznego archiwum.
Dane między instancjami PBS mogą być przesyłane w modelu Pull lub Push, w zależności od architektury sieciowej oraz reguł na firewallach:
- Model Push: Główny serwer wpycha dane do archiwum. Jest to rozwiązanie stosowane wtedy, gdy polityki bezpieczeństwa bezwzględnie zabraniają wpuszczania jakiegokolwiek ruchu przychodzącego do głównej lokalizacji.
- Model Pull (rekomendowany dla bezpieczeństwa): Serwer archiwalny samodzielnie inicjuje połączenie i „zasysa” dane z serwera głównego. W tym scenariuszu, nawet jeśli atakujący całkowicie przejmie główny serwer backupu, nie znajdzie na nim poświadczeń pozwalających na modyfikację czy usunięcie kopii w archiwum. Wymaga to jednak udostępnienia punktu końcowego głównego serwera na zewnątrz (np. poprzez przekierowanie portów lub dedykowany tunel VPN).
Ciekawym podejściem hybrydowym może być na przykład uruchomienie archiwalnego serwera PBS na maszynie wirtualnej w chmurze Microsoft Azure, a następnie zabezpieczanie samej tej maszyny natywnymi mechanizmami Azure Backup, które opisywaliśmy wcześniej. Każda organizacja posiada inną infrastrukturę, inne procesy oraz odmienne wymagania biznesowe i prawne, dlatego kluczem do sukcesu jest zawsze precyzyjne dobranie architektury i rozwiązań do realnych potrzeb oraz budżetu Waszej firmy.
Pamiętajcie też, że infrastruktura self-hosted wymaga sama w sobie odpowiedniej higieny operacyjnej i wysokich standardów bezpieczeństwa. Wymusza ona na Was samodzielne zadbanie o redundancję sprzętową (redundantne zasilacze, macierze dyskowe RAID), pełne szyfrowanie nośników danych (at rest), właściwą konfigurację firewalla na hoście, przemyślaną segmentację w sieci lokalnej, a także regularne instalowanie aktualizacji. Tylko wtedy kopie zapasowe przechowywane w takim środowisku będą faktycznie odporne na awarie i ataki.